


语音识别算法工程师简历范文全文

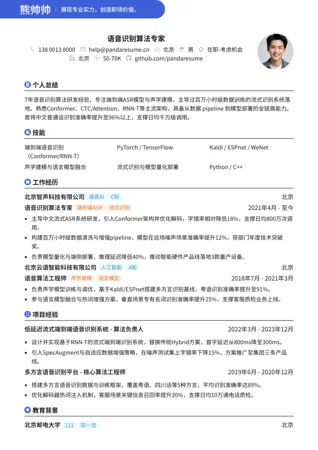
你好,我是熊帅帅
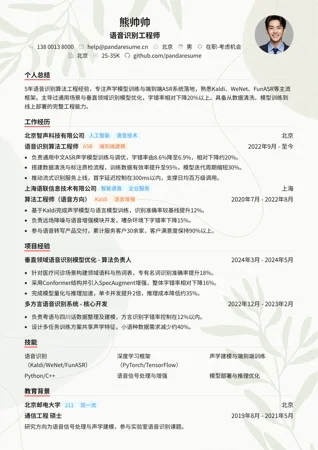
语音识别算法工程师
自我评价
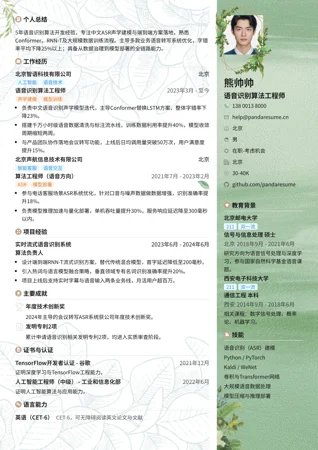
5年语音识别算法研发经验,专注端到端ASR建模、声学模型优化与流式解码,熟悉Conformer、Transformer及RNN-T等主流架构。主导过千万小时级数据训练与模型压缩落地,将中文识别字错率降低18%,端到端延迟压缩至300ms以内。具备从算法研究到工程部署的完整闭环能力,熟悉Kaldi、WeNet、FunASR等开源框架。
工作经历
北京智声科技有限公司
人工智能语音技术
北京
语音识别算法工程师
端到端ASR模型优化
2022年9月 - 至今
- 负责中文通用ASR声学模型迭代,引入Conformer架构并优化数据增强策略,测试集字错率由8.6%降至7.1%。
- 主导流式识别解码优化,通过分块注意力与缓存机制将首字延迟从520ms降至280ms,支撑实时字幕业务上线。
- 搭建模型量化与蒸馏流水线,模型体积压缩60%、推理耗时下降45%,单卡并发提升2.3倍。
上海云语智能科技有限公司
智能语音创业公司
上海
算法工程师(语音方向)
远场识别领域自适应
2020年7月 - 2022年8月
- 参与远场语音识别系统研发,完成前端降噪与声学模型联合调优,嘈杂场景识别准确率提升12%。
- 负责热词与领域自适应方案落地,定制词识别召回率由76%提升至91%,服务金融客服场景。
项目经验
多方言中文语音识别系统 - 算法负责人
2024年3月 - 2024年5月
- 构建覆盖8种方言的混合训练数据方案,采用语种向量与共享编码器,平均字错率较基线下降15%。
- 设计方言自适应微调流程,单方言冷启动数据需求降低70%,两周内完成新方言上线。
实时会议转写引擎 - 核心算法开发
2022年12月 - 2023年2月
- 实现流式RNN-T解码与端点检测联动,会议场景整句识别准确率达94.5%。
- 优化标点与逆文本规整模块,转写可读性显著提升,支撑产品日均处理音频超5万小时。
专业技能
PyTorch / 深度学习框架
端到端ASR建模(Conformer/RNN-T)
Kaldi / WeNet / FunASR
Python / C++
流式解码与模型压缩
语音信号处理与数据增强
教育背景
中国科学院大学
双一流科研院所
北京
信号与信息处理 硕士
2019年8月 - 2021年5月
研究方向为语音识别与声学建模,参与国家自然科学基金语音项目。
西安电子科技大学
211双一流
西安
电子信息工程 本科
2016年8月 - 2020年5月
核心课程:数字信号处理、模式识别、机器学习。
证书与认证
软件设计师(软考中级) - 工业和信息化部
2019年11月
证明软件设计与工程能力。
大学英语六级(CET-6) - 教育部考试中心
2015年12月
具备英文技术文献阅读能力。
荣誉奖项
中国科学院大学优秀毕业生
全国大学生电子设计竞赛省级一等奖
就从这份范文开始
免费复制到你的账户里,每一句话、每个板块和颜色都能改,改好即可下载投递。