


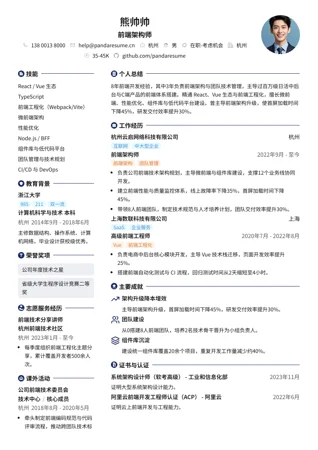
自然语言处理算法研究员简历范文全文
自我评价
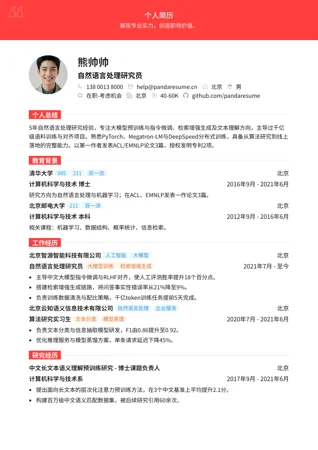
5年自然语言处理算法研究与落地经验,专注大模型预训练、指令微调与检索增强生成方向,主导过千亿级语料训练与线上推理优化。熟悉PyTorch、Megatron-LM与vLLM,具备从论文复现到业务上线的完整闭环能力。累计发表ACL/EMNLP论文3篇,申请发明专利2项。
工作经历
北京智源人工智能研究院
北京
人工智能研究院大模型
自然语言处理算法研究员
2022年9月 - 至今
指令微调RAG
- 主导70B参数中文大模型指令微调,构建50万条高质量SFT数据,在C-Eval上提升6.2分。
- 设计RAG检索增强方案并上线企业知识问答,答案准确率由71%提升至88%,日均调用超20万次。
- 负责推理侧vLLM量化与批处理优化,单卡吞吐提升2.3倍,推理成本下降约40%。
北京字节跳动科技有限公司
北京
互联网大厂内容平台
算法工程师(NLP方向)
2020年7月 - 2022年8月
文本分类语义匹配
- 负责文本分类与语义匹配模型迭代,线上F1由0.86提升至0.92,支撑日均亿级请求。
- 搭建多语言预训练数据清洗流水线,去重与质量过滤后训练语料有效率提升35%。
研究经历
面向中文长文本的预训练语言模型高效建模/博士课题负责人
北京
计算机科学与技术系
2020年1月 - 2020年6月
- 提出稀疏注意力与段落级记忆机制,长文本理解任务平均提升4.1个点,成果发表于ACL 2020。
- 构建中文长文档摘要数据集并开源,累计获得GitHub 1.2k Star,被多所高校引用。
跨语言语义表示对齐研究/核心研究员
北京
自然语言处理实验室
2019年9月 - 2019年12月
- 设计对比学习对齐框架,跨语言检索Recall@10提升8.5个点,成果发表于EMNLP 2020。
- 参与国家自然科学基金项目申报与结题,负责实验设计与论文撰写。
项目经验
企业级检索增强问答系统
2024年3月 - 2024年5月
算法负责人
- 设计混合检索与重排序链路,召回率提升至93%,幻觉率下降约30%。
- 搭建自动化评测集与badcase回流机制,迭代周期由两周缩短至三天。
中文大模型指令数据集构建
2022年12月 - 2023年2月
核心开发
- 制定数据标注规范并管理30人标注团队,产出50万条高质量指令数据。
- 引入模型自动打分与人工抽检双重质检,数据合格率稳定在96%以上。
工作成果
顶会论文发表
以第一作者在ACL、EMNLP发表论文3篇,谷歌学术引用累计260余次。
发明专利
申请大模型推理加速与检索增强相关发明专利2项,均已进入实审阶段。
开源贡献
开源中文长文本摘要数据集与训练代码,GitHub累计1.2k Star。
语言能力
英语(CET-6)可熟练阅读英文论文并撰写英文投稿,具备国际会议报告经验。

教育背景
清华大学
985211双一流
计算机科学与技术 博士
北京2016年9月 - 2021年6月
研究方向:自然语言处理与深度学习;在ACL、EMNLP发表一作论文2篇。
哈尔滨工业大学
985211双一流
计算机科学与技术 本科
哈尔滨2012年9月 - 2016年6月
专业排名前5%,核心课程:机器学习、数据结构、概率论与数理统计。
专业技能
大模型预训练与微调
PyTorch / Megatron-LM
检索增强生成(RAG)
vLLM / TensorRT-LLM 推理优化
Python / C++
Transformer 架构与论文复现
荣誉奖项
中国计算机学会(CCF)优秀博士学位论文奖
国家奖学金
全国大学生数学建模竞赛国家一等奖
更多自然语言处理简历范文
同一职位,不同的版式和写法。点开任意一份即可查看大图。
就从这份范文开始
免费复制到你的账户里,每一句话、每个板块和颜色都能改,改好即可下载投递。