


自然语言处理研究员简历范文全文
个人简历
展现专业实力,创造职场价值。


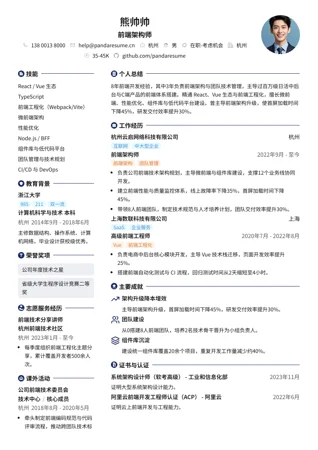
自我评价
5年自然语言处理研究经验,专注大模型预训练与指令微调、检索增强生成及文本理解方向,主导过千亿级语料训练与对齐项目。熟悉PyTorch、Megatron-LM与DeepSpeed分布式训练,具备从算法研究到线上落地的完整能力。以第一作者发表ACL/EMNLP论文3篇,授权发明专利2项。
教育背景
清华大学
985211双一流
北京
计算机科学与技术 博士
2016年9月 - 2021年6月
研究方向为自然语言处理与机器学习;在ACL、EMNLP发表一作论文3篇。
北京邮电大学
211双一流
北京
计算机科学与技术 本科
2012年9月 - 2016年6月
相关课程:机器学习、数据结构、概率统计、信息检索。
工作经历
北京智源智能科技有限公司
人工智能大模型
北京
自然语言处理研究员
大模型训练检索增强生成
2021年7月 - 至今
- 主导中文大模型指令微调与RLHF对齐,使人工评测胜率提升18个百分点。
- 搭建检索增强生成链路,将问答事实性错误率从21%降至9%。
- 负责训练数据清洗与配比策略,千亿token训练任务提前5天完成。
北京云知语义信息技术有限公司
自然语言处理企业服务
北京
算法研究实习生
文本分类模型蒸馏
2020年7月 - 2021年6月
- 负责文本分类与信息抽取模型研发,F1由0.86提升至0.92。
- 优化推理服务与模型蒸馏方案,单条请求延迟下降45%。
研究经历
中文长文本语义理解预训练研究 - 博士课题负责人
北京
计算机科学与技术系
2017年9月 - 2021年6月
- 提出面向长文本的层次化注意力预训练方法,在3个中文基准上平均提升2.1分。
- 构建百万级中文语义匹配数据集,被后续研究引用60余次。
项目经验
中文大模型指令微调与对齐项目 - 算法负责人
2023年3月 - 2024年8月
- 设计多阶段指令数据构造与偏好对齐流程,覆盖12类任务场景。
- 上线后模型在内部评测集准确率提升14%,日均调用量突破200万次。
工作成果
顶会论文发表
以第一作者在ACL、EMNLP发表论文3篇,累计引用180余次。
技术方案规模化复用
主导的检索增强问答方案在公司3条业务线复用,年节省标注成本约120万元。
专业技能
PyTorch / 分布式训练
大模型预训练与指令微调
检索增强生成(RAG)
Transformer / 注意力机制
Python / C++
Megatron-LM / DeepSpeed
文本分类与信息抽取
模型压缩与推理优化
论文写作与实验设计
荣誉奖项
研究生国家奖学金
CCF NLP优秀论文奖
证书与认证
深度学习工程师认证 - 中国人工智能学会
2023年6月
证明深度学习框架与模型工程能力。
阿里云人工智能工程师认证(ACP) - 阿里云
2022年12月
证明云计算平台使用与部署能力。
语言能力
英语CET-6,可无障碍阅读英文论文并进行学术交流
更多自然语言处理简历范文
同一职位,不同的版式和写法。点开任意一份即可查看大图。
就从这份范文开始
免费复制到你的账户里,每一句话、每个板块和颜色都能改,改好即可下载投递。