


自然语言处理研发工程师简历范文全文

自我评价
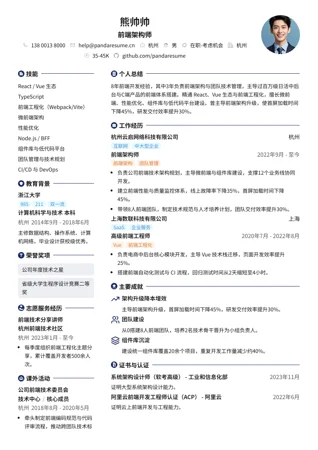
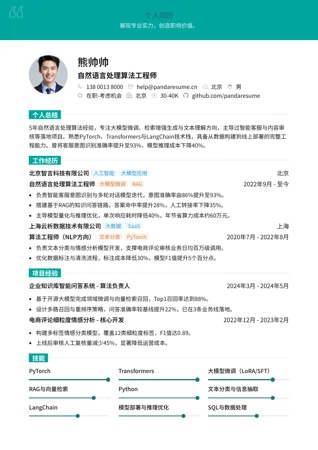
5年自然语言处理研发经验,专注大模型微调、检索增强生成与文本理解方向,主导过千万级用户场景的智能问答与内容审核系统。熟悉PyTorch、Transformers、vLLM等技术栈,具备从数据构建、模型训练到线上部署的全链路落地能力。曾将问答系统准确率提升12个百分点,推理成本下降40%。
工作经历
北京智言科技有限公司
人工智能大模型
北京
自然语言处理研发工程师
大模型微调RAG
2022年9月 - 至今
- 负责企业级智能问答系统的大模型微调与RAG链路建设,问答准确率从78%提升至90%。
- 主导推理服务优化,引入vLLM与量化方案,单次响应成本下降40%,P99延迟降至300ms。
- 搭建文本数据清洗与指令数据生产流程,累计产出高质量训练样本80万条。
上海云析信息技术有限公司
互联网内容平台
上海
算法工程师(NLP方向)
文本分类模型部署
2020年7月 - 2022年8月
- 负责内容审核文本模型研发,覆盖垃圾广告与违规文本识别,召回率提升9个百分点。
- 基于BERT完成多标签分类与情感分析模型迭代,线上F1由0.82提升至0.89。
- 参与模型服务化与A/B实验,支撑日均千万级文本请求稳定运行。
项目经验
企业知识库智能问答系统 - NLP算法负责人
2024年3月 - 2024年5月
- 设计检索增强生成方案,结合向量召回与重排序,答案命中率提升至92%。
- 构建领域指令数据集并完成LoRA微调,人工评测满意度由3.6分提升至4.4分(5分制)。
多标签内容审核模型升级 - 核心算法工程师
2022年12月 - 2023年2月
- 采用预训练模型加对抗训练优化长尾类别,违规文本召回率提升9个百分点。
- 完成模型蒸馏与TensorRT加速,单卡吞吐提升2.3倍,满足线上实时审核要求。
专业技能
PyTorch / Transformers
大模型微调(LoRA/SFT)
RAG与向量检索
Python
文本分类与信息抽取
vLLM / 模型部署优化
教育背景
北京邮电大学
211双一流
北京
计算机科学与技术 硕士
2019年8月 - 2021年5月
研究方向为自然语言处理,主修机器学习、深度学习、信息检索。
武汉理工大学
211双一流
武汉
软件工程 本科
2016年8月 - 2020年5月
主修数据结构、算法设计与数据库系统,GPA 3.6/4.0。
荣誉奖项
中国计算机学会(CCF)NLP方向优秀论文奖
校级优秀毕业生
证书与认证
计算机技术与软件专业技术资格(软件设计师) - 工业和信息化部
2019年5月
具备软件设计与开发能力。
大学英语六级(CET-6) - 教育部考试中心
2015年12月
可流畅阅读英文技术文献。
更多自然语言处理简历范文
同一职位,不同的版式和写法。点开任意一份即可查看大图。
就从这份范文开始
免费复制到你的账户里,每一句话、每个板块和颜色都能改,改好即可下载投递。