


机器学习平台简历范文全文

自我评价
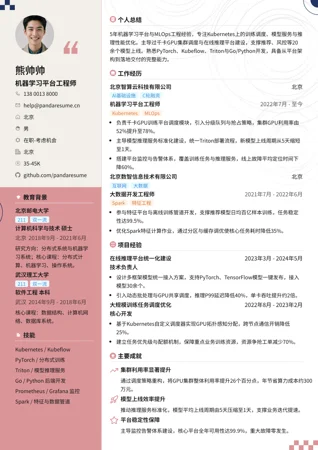
5年机器学习平台与MLOps工程经验,主导过千卡GPU集群调度与训练平台建设,熟悉Kubernetes、Kubeflow与PyTorch生态。擅长训练任务编排、模型服务化与推理性能优化,支撑公司20余个算法团队日常研发。具备从0到1搭建平台并推动落地的完整经验。
工作经历
北京智算云科技有限公司
AI基础设施云计算
北京
机器学习平台工程师
KubernetesMLOps
2022年9月 - 至今
- 负责训练平台调度模块研发,基于Kubernetes与Volcano实现GPU分时复用,集群利用率由42%提升至68%。
- 主导模型推理服务化改造,引入Triton与动态批处理,线上P99延迟下降35%,单卡吞吐提升1.8倍。
- 搭建平台监控与告警体系,覆盖200余个训练任务,故障平均定位时间从2小时缩短至20分钟。
上海数联科技有限公司
SaaS企业数据
上海
算法平台开发工程师
特征工程Python
2020年7月 - 2022年8月
- 参与特征平台建设,统一管理3000余个特征,特征复用率提升至60%,模型上线周期缩短一周。
- 开发实验管理与模型版本追踪工具,支撑算法团队每月200余次实验,实验可复现率提升至95%。
项目经验
千卡GPU训练平台建设 - 平台技术负责人
2024年3月 - 2024年5月
- 设计多租户训练任务编排方案,支持优先级抢占与弹性队列,支撑20余个算法团队并发训练。
- 集成分布式训练框架与断点续训能力,千卡规模任务失败重跑率下降50%,训练成本节约约30%。
- 推动平台在集团内推广落地,月均训练任务量从800次增长至3500次。
在线推理服务平台优化 - 核心开发
2022年12月 - 2023年2月
- 重构模型加载与热更新流程,模型上线耗时从30分钟降至3分钟,支持灰度发布与快速回滚。
- 引入GPU显存池化与量化推理,单机部署模型数量提升2倍,推理资源成本下降25%。
专业技能
Kubernetes
PyTorch
Python
Kubeflow
Triton推理服务
Go
Prometheus监控
分布式训练
SQL
教育背景
北京邮电大学
211双一流
北京
计算机科学与技术 硕士
2019年8月 - 2021年5月
研究方向为分布式机器学习系统,参与实验室GPU集群调度课题。
武汉理工大学
211双一流
武汉
软件工程 本科
2016年8月 - 2020年5月
主修数据结构、操作系统、机器学习导论等课程。
证书与认证
CKA(Certified Kubernetes Administrator) - Linux基金会
2023年5月
证明Kubernetes集群部署与运维能力。
系统架构设计师(软考高级) - 工业和信息化部
2022年11月
证明大型系统架构设计能力。
荣誉奖项
公司年度技术创新奖
校级优秀毕业生
更多机器学习简历范文
同一职位,不同的版式和写法。点开任意一份即可查看大图。
就从这份范文开始
免费复制到你的账户里,每一句话、每个板块和颜色都能改,改好即可下载投递。