


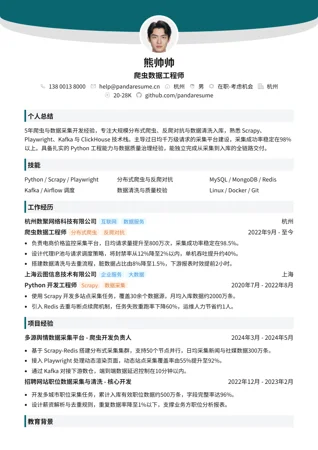
电商爬虫工程师简历范文全文

熊帅帅
电商爬虫工程师
教育背景
武汉理工大学
211双一流
计算机科学与技术 本科
武汉2016年9月 - 2020年6月
主修数据结构、计算机网络、数据库系统,毕业设计为分布式网页采集系统。
华中科技大学
985双一流
软件工程 硕士
武汉2020年9月 - 2023年6月
研究方向为网络数据采集与反爬对抗,参与电商价格监测课题。
专业技能
Python / Scrapy
Playwright / 逆向分析
分布式调度与代理池
MySQL / Redis
MongoDB / 数据清洗
Docker / Linux 运维
荣誉奖项
国家奖学金
全国大学生软件测试大赛二等奖
年度优秀员工
自我评价
5年Python爬虫开发经验,专注电商平台商品、价格与评论数据采集,熟悉主流平台反爬机制与风控对抗。精通Scrapy、Playwright、分布式调度与代理池建设,日均稳定采集千万级数据。主导亿级商品库数据管道搭建,采集成功率提升至98%以上。
工作经历
杭州云采数据科技有限公司
杭州
电商数据服务高新技术企业
电商爬虫工程师
2023年7月 - 至今
Python反爬对抗
- 负责淘宝、京东、拼多多等平台商品与价格数据采集,日均稳定抓取800万条,任务成功率提升至98%。
- 设计分布式爬虫调度与动态代理池方案,单机采集效率提升60%,封禁率下降至3%以内。
- 搭建数据清洗与去重管道,商品库重复率由12%降至1.5%,支撑下游比价业务稳定运行。
武汉数聚信息技术有限公司
武汉
互联网数据采集
Python爬虫开发工程师
2020年7月 - 2023年6月
Scrapy数据清洗
- 使用Scrapy与Playwright开发多站点采集任务,覆盖30余个电商站点,月均产出数据2亿条。
- 完成验证码识别与登录态维护模块,采集中断率降低45%,人工干预频次减少七成。
- 参与MongoDB存储结构优化,查询响应时间从800ms降至200ms,支撑运营实时看板。
项目经验
电商全平台商品价格监测系统
2024年3月 - 2025年6月
爬虫架构负责人
- 主导设计分布式采集架构,接入200+代理节点与任务队列,支撑日均千万级请求稳定运行。
- 建立风控监测与自动降级机制,异常封禁自动切换策略,整体采集成功率稳定在98%以上。
竞品评论数据采集与分析平台
2023年8月 - 2024年2月
核心开发工程师
- 开发评论采集与情感标签管道,累计沉淀评论数据1.2亿条,为选品分析提供数据基础。
- 引入增量采集与断点续爬机制,重复请求减少55%,服务器资源成本下降约三成。
工作成果
采集成功率提升至98%
通过代理池与调度优化,将整体采集成功率从85%提升至98%以上。
采集效率提升60%
重构采集任务调度,单机日采集量提升60%,服务器成本下降约25%。
沉淀反爬策略库
建立反爬策略库,覆盖主流电商平台20余种风控场景,维护成本显著降低。
证书与认证
阿里云大数据工程师认证(ACP) - 阿里云
2024年3月
证明云上数据采集与处理能力。
数据库系统工程师(软考中级) - 工业和信息化部
2022年11月
证明数据库设计与管理能力。
更多爬虫工程师简历范文
同一职位,不同的版式和写法。点开任意一份即可查看大图。
就从这份范文开始
免费复制到你的账户里,每一句话、每个板块和颜色都能改,改好即可下载投递。