


AI自然语言处理训练师简历范文全文

自我评价
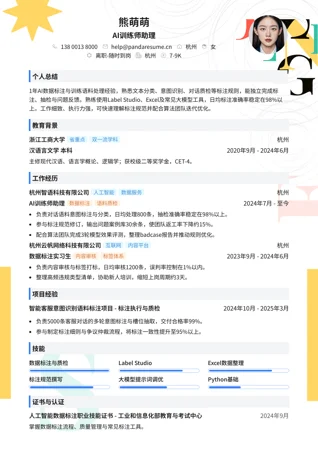
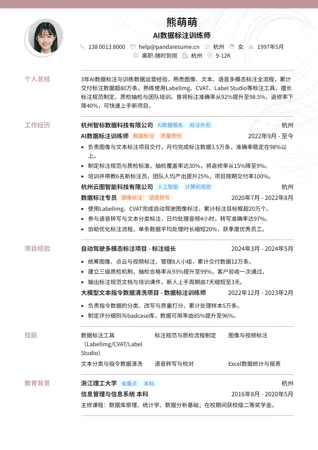
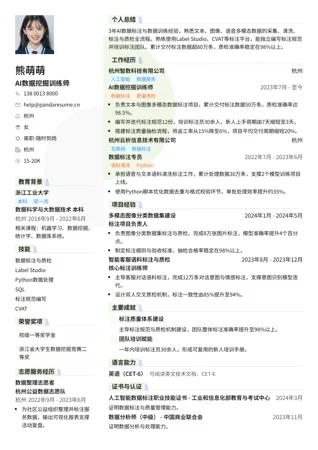
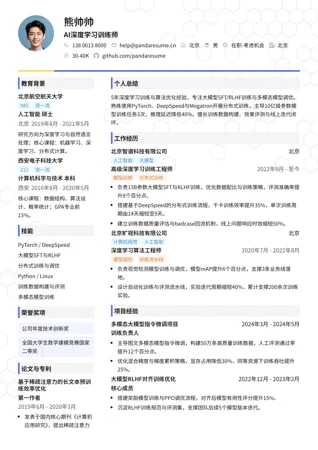
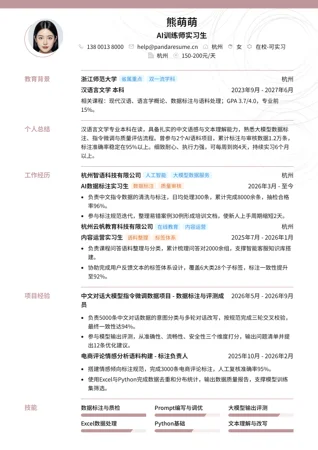
3年AI自然语言处理训练与数据标注管理经验,熟悉大模型SFT指令微调、RLHF偏好数据构建与评测体系搭建。擅长标注规范设计、标注团队管理与质量抽检,累计交付10万+条高质量语料。具备Prompt工程与文本分类、意图识别项目落地经验,能独立完成从数据到模型效果验证的闭环。
工作经历
杭州智言科技有限公司
人工智能大模型应用
杭州
AI自然语言处理训练师
数据标注SFT微调
2022年9月 - 至今
- 负责大模型SFT指令数据构建,设计12类任务标注规范,累计交付8万+条高质量语料,标注一次通过率提升至92%。
- 搭建标注质量抽检与复核机制,将返工率从18%降至6%,单项目交付周期缩短5个工作日。
- 参与RLHF偏好数据标注与评测集建设,输出badcase分析报告30余份,支撑模型意图识别准确率提升7个百分点。
上海语析信息技术有限公司
互联网智能客服
上海
NLP数据标注专员
文本标注质量抽检
2020年7月 - 2022年8月
- 负责文本分类与意图识别语料标注,月均处理1.2万条数据,个人准确率稳定在95%以上。
- 参与标注平台规则优化,梳理常见歧义场景40余例,形成内部标注FAQ,新人上手周期缩短3天。
项目经验
智能客服意图识别语料优化项目 - NLP训练数据负责人
2024年3月 - 2024年5月
- 主导梳理客服场景200+意图标签体系,重构标注规范并培训15人标注团队,标签一致性达90%。
- 构建分层评测集并输出迭代建议,推动意图识别准确率由81%提升至89%,人工转接率下降12%。
大模型指令微调数据集建设项目 - 数据构建与评测
2022年12月 - 2023年2月
- 设计多轮对话与指令遵循数据模板,完成3万条样本清洗与去重,数据可用率提升至96%。
- 建立人工评分与自动指标结合的评测流程,输出模型对比报告,支撑两轮版本迭代决策。
教育背景
浙江工业大学
省重点双一流学科
杭州
汉语言文学 本科
2016年8月 - 2020年5月
主修现代汉语、语言学概论与语料库语言学;CET-6,普通话二级甲等。
专业技能
大模型SFT数据构建
标注规范设计与质量抽检
RLHF偏好数据标注
Prompt工程与评测设计
文本分类与意图识别
Python数据处理(Pandas)
证书与认证
人工智能训练师(三级) - 人力资源和社会保障部
2023年9月
具备AI数据标注与模型训练相关职业能力认证。
大学英语六级(CET-6) - 教育部教育考试院
2020年12月
具备英文技术文档阅读与英文语料处理能力。
工作成果
标注效率提升
主导标注流程标准化,团队人均日产能提升35%。
内部优秀员工
2024年获公司年度优秀员工,年度绩效评级A。
规范沉淀
编写标注规范手册与FAQ共6份,被3个项目组复用。
就从这份范文开始
免费复制到你的账户里,每一句话、每个板块和颜色都能改,改好即可下载投递。