


云计算运维总监简历范文全文

自我评价
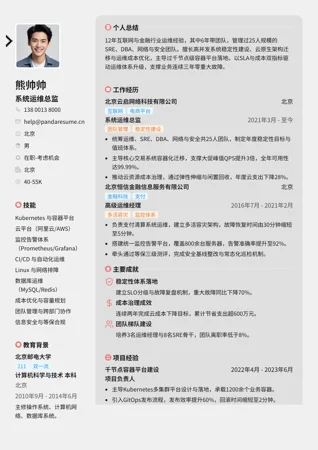
12年云计算与IT运维经验,其中5年团队管理经验,负责过千台级混合云资源池的稳定性与成本治理。精通Kubernetes、OpenStack、Terraform与Prometheus监控体系,主导过云平台迁移与SRE体系建设。擅长以SLA、可用性和成本指标驱动运维团队交付,支撑业务高速增长。
工作经历
北京云启数字科技有限公司
云计算服务高新技术企业
北京
云计算运维总监
团队管理SRE体系
2022年9月 - 至今
- 统筹30人运维与SRE团队,负责2000+台云主机与多集群Kubernetes平台,核心业务可用性稳定在99.95%。
- 推行自动化巡检与容量预测,年度云资源成本下降28%,故障平均恢复时间由45分钟缩短至12分钟。
- 建立7×24值班与应急响应机制,主导完成3次重大活动保障,实现零重大事故。
上海联信网络技术有限公司
互联网电商中型企业
上海
高级运维经理
云迁移自动化运维
2020年7月 - 2022年8月
- 负责电商核心系统运维,主导IDC向阿里云迁移,迁移期间业务零中断,资源交付效率提升60%。
- 搭建Prometheus+Grafana监控告警体系,覆盖800+服务实例,告警准确率提升至92%。
- 推动CI/CD与基础设施即代码落地,版本发布频率由每周1次提升至每日多次。
项目经验
混合云资源池统一纳管与成本治理 - 项目负责人
2024年3月 - 2024年5月
- 主导建设多云统一纳管平台,接入阿里云、腾讯云与自建机房共2000+节点,实现资源台账与账单可视化。
- 通过闲置资源回收与弹性伸缩策略,年度云支出节省约420万元,资源利用率提升35%。
- 建立成本分摊与预算预警机制,推动各业务线成本意识落地。
核心业务容器化与SRE体系建设 - 技术负责人
2022年12月 - 2023年2月
- 推动核心交易系统容器化改造,完成200+微服务上Kubernetes,发布效率提升3倍。
- 制定SLO/SLI指标体系与错误预算机制,季度故障数下降50%。
专业技能
Kubernetes与容器云运维
阿里云/腾讯云多云管理
Terraform与Ansible自动化
Prometheus/Zabbix监控体系
Linux系统与网络排障
SRE与成本治理(FinOps)
证书与认证
阿里云云计算架构师认证(ACE) - 阿里云
2022年6月
证明云架构设计与多云治理能力。
信息系统项目管理师(软考高级) - 工业和信息化部
2019年11月
证明大型IT项目与团队管理能力。
教育背景
北京邮电大学
211双一流
北京
计算机科学与技术 本科
2008年9月 - 2012年6月
主修操作系统、计算机网络与数据库系统,获校级优秀毕业生。
工作成果
成本显著优化
连续两年推动云成本治理,累计节省支出超600万元。
稳定性提升
核心系统年度可用性由99.8%提升至99.95%,达到行业领先水平。
团队建设
从0搭建30人SRE团队,培养5名运维骨干晋升为技术负责人。
就从这份范文开始
免费复制到你的账户里,每一句话、每个板块和颜色都能改,改好即可下载投递。