


高性能计算工程师简历范文全文

个人简历
展现专业实力,创造职场价值。
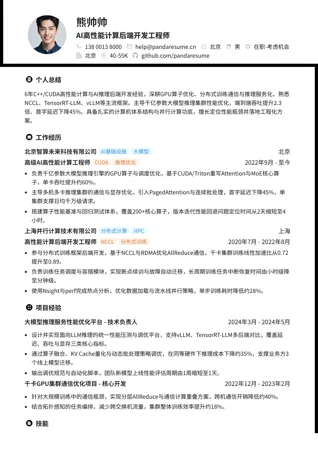
熊帅帅
高性能计算工程师
自我评价
6年高性能计算研发经验,专注GPU异构计算、MPI/OpenMP并行优化与大规模集群性能调优,熟悉CUDA、NCCL及国产加速卡生态。主导过千卡级训练集群通信优化与科学计算内核加速,累计将核心算子性能提升2倍以上。具备扎实的C++与体系结构功底,能独立完成从性能剖析到落地上线的全流程。
专业技能
CUDA / GPU 异构编程
MPI / OpenMP 并行编程
C++ / 现代 C++ 性能优化
性能剖析(Nsight / perf / VTune)
Slurm / 集群调度与运维
Python / 自动化测试脚本
工作经历
北京某智能计算科技有限公司
人工智能算力服务
北京
高性能计算工程师
CUDAMPI
2022年9月 - 至今
- 负责千卡级GPU训练集群通信优化,基于NCCL与自研AllReduce策略将大模型训练吞吐提升约35%。
- 主导科学计算核心内核CUDA重构,单卡算子性能提升2.1倍,支撑3个业务线按期交付。
- 搭建性能回归与压测平台,将集群故障定位时间从小时级缩短至15分钟内。
上海某科学计算软件有限公司
工业软件科学计算
上海
并行计算研发工程师
OpenMP性能调优
2020年7月 - 2022年8月
- 参与流体仿真求解器MPI并行化改造,支持万核规模扩展,并行效率保持在78%以上。
- 优化内存访问与向量化指令,单节点计算耗时降低约40%,客户验收一次通过。
项目经验
千卡级大模型训练通信优化 - 技术负责人
2024年3月 - 2024年5月
- 针对AllReduce通信瓶颈设计分层拓扑感知算法,端到端训练迭代时间缩短28%。
- 联合网络团队完成RDMA参数调优,跨节点带宽利用率由62%提升至89%。
国产加速卡算子迁移与加速 - 核心开发
2022年12月 - 2023年2月
- 完成12个高频算子从CUDA到国产加速卡的迁移适配,精度误差控制在1e-5以内。
- 通过流水线与共享内存优化,整体推理时延下降约30%,通过业务方验收。
教育背景
哈尔滨工业大学
985双一流
哈尔滨
计算机科学与技术 硕士
2019年8月 - 2021年5月
研究方向:并行计算与体系结构;参与国家自然科学基金高性能计算课题。
西安电子科技大学
211双一流
西安
软件工程 本科
2016年8月 - 2020年5月
主修数据结构、操作系统、计算机组成原理;CET-6。
工作成果
集群性能突破
主导的通信优化方案在公司内部推广至5个训练集群,年节省算力成本约200万元。
技术竞赛获奖
获全国并行应用挑战赛(PAC)二等奖,参赛作品为GPU加速的分子动力学模拟。
专利与沉淀
作为第一发明人申请并行调度相关发明专利1项,输出内部性能优化规范文档3篇。
证书与认证
NVIDIA Certified Associate: AI Infrastructure and Operations - NVIDIA
2023年8月
证明GPU基础设施部署与运维能力。
系统架构设计师(软考高级) - 工业和信息化部
2021年11月
证明大型系统架构设计能力。
其他信息
到岗时间:
在职,确认录用后一个月内到岗。
工作安排:
可接受短期出差及驻场支持。
技术输出:
GitHub 维护并行优化示例代码库,累计 Star 300+。
更多高性能计算工程师简历范文
同一职位,不同的版式和写法。点开任意一份即可查看大图。
就从这份范文开始
免费复制到你的账户里,每一句话、每个板块和颜色都能改,改好即可下载投递。