


Hadoop数据建模工程师简历范文全文
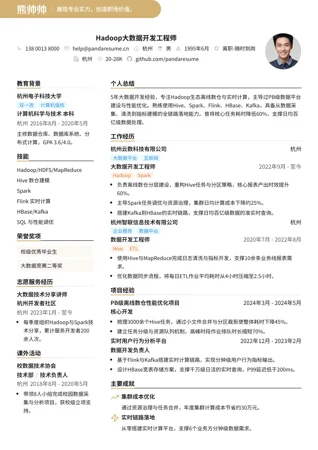
熊帅帅
展现专业实力,创造职场价值。Hadoop数据建模工程师

教育背景
武汉理工大学
211双一流
计算机科学与技术 本科
武汉2014年9月 - 2018年6月
主修数据仓库、数据库系统与分布式计算,毕业设计为基于Hive的数仓建模。
专业技能
Hive数据建模
Hadoop/HDFS
Spark SQL
维度建模
HBase
SQL调优
荣誉奖项
校级一等奖学金
优秀毕业生
志愿服务经历
数据整理志愿者
武汉市青年数据志愿队
武汉2017年3月 - 2018年5月
- 为社区小微企业提供数据整理与报表培训,累计服务30余家。
课外活动
数据技术协会
计算机学院/技术组组长
武汉2016年9月 - 2017年12月
- 组织6人小组完成校园二手交易平台的数据统计模块开发。
自我评价
6年大数据开发与数据建模经验,深耕Hadoop生态,熟练使用Hive、Spark、HBase完成离线数仓分层建模与性能调优。主导过PB级数仓重构与实时链路建设,具备从需求调研到模型落地的完整交付能力。擅长维度建模与数据治理,累计支撑业务报表上百张。
工作经历
杭州云数信息技术有限公司
杭州
大数据服务电商
Hadoop数据建模工程师
2021年4月 - 至今
Hive维度建模
- 负责电商数仓ODS到DWD分层建模,重构核心订单模型,报表产出时效提升40%。
- 优化Hive与Spark任务参数及分区策略,日均计算资源消耗下降约25%。
- 制定建模规范与数据字典,支撑8个业务团队自助取数,需求响应周期缩短一半。
浙江数聚网络科技有限公司
杭州
互联网数据平台
大数据开发工程师
2018年7月 - 2021年3月
SparkHBase
- 参与PB级用户行为数仓建设,设计埋点宽表与汇总层模型,支撑日活分析看板。
- 使用HBase与Spark完成标签数据加工,标签计算任务耗时由6小时降至2小时。
- 配合数据治理专项,清理冗余表300余张,存储成本降低约18%。
项目经验
电商PB级数仓分层重构
2022年3月 - 2023年6月
数据建模负责人
- 主导订单、商品、用户三大主题域模型重构,输出分层设计文档与规范。
- 通过拉链表与增量抽取改造,核心报表出数时间由T+1提前至当日凌晨。
用户行为实时分析链路建设
2024年1月 - 2024年5月
核心开发
- 搭建用户行为实时汇总链路,支撑大促期间分钟级监控看板。
- 优化Spark任务并行度与数据倾斜,链路稳定性提升至99.9%。
工作成果
建立建模规范体系
牵头制定公司数仓建模与命名规范,被3个业务线采纳为统一标准。
集群成本优化
通过存储与计算优化,年度集群资源成本节约约35万元。
年度优秀员工
连续两年获评公司年度优秀员工,绩效评级A。
其他信息
到岗时间:
可接受短期出差,一周内到岗。
作品集:
github.com/xiong-shuaishuai(数仓建模示例与脚本)。
证书与认证
阿里云大数据工程师认证(ACP) - 阿里云
2023年9月
证明大数据平台规划与数仓建模能力。
数据库系统工程师(软考中级) - 工业和信息化部
2022年5月
证明数据库设计与优化能力。
更多Hadoop简历范文
同一职位,不同的版式和写法。点开任意一份即可查看大图。
就从这份范文开始
免费复制到你的账户里,每一句话、每个板块和颜色都能改,改好即可下载投递。