


Hadoop数据处理工程师简历范文全文

自我评价
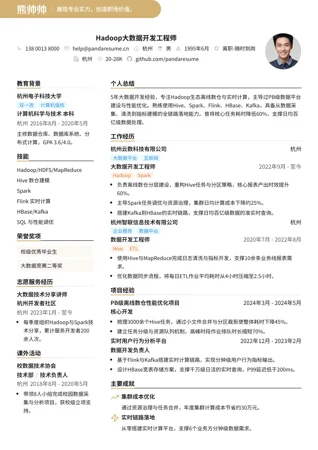
5年大数据平台开发经验,专注Hadoop生态离线数仓建设与海量数据处理,熟练使用Hive、Spark、HDFS与Kafka。主导过PB级数据仓库分层重构与任务性能优化,日均处理数据量提升至30TB,核心任务耗时下降40%。具备扎实的SQL调优与数据治理能力,能独立完成从采集、清洗到建模的全链路交付。
专业技能
Hadoop/HDFS/MapReduce
Hive SQL与数仓建模
Spark(Scala/PySpark)
Kafka/Flink实时链路
Python数据脚本开发
Linux/Shell与调度(Azkaban/DolphinScheduler)
工作经历
杭州云数信息技术有限公司
大数据服务互联网
杭州
Hadoop数据处理工程师
Hadoop数据仓库
2022年9月 - 至今
- 负责离线数仓分层建设,重构ODS至DWD链路,日均处理数据量由12TB提升至30TB。
- 优化Hive与Spark任务共200余个,核心报表产出时间由4小时缩短至2.4小时。
- 搭建数据质量监控与任务告警体系,数据异常发现时效由天级提升至小时级。
上海数联科技有限公司
SaaS企业数据
上海
大数据开发工程师
SparkETL
2020年7月 - 2022年8月
- 参与用户行为日志采集与清洗,基于Flume与Kafka构建稳定数据接入通道,日接入量达8TB。
- 使用Spark完成用户画像标签计算,支撑运营圈选场景,标签覆盖率提升至92%。
项目经验
PB级离线数仓分层重构项目 - 数据开发负责人
2024年3月 - 2024年5月
- 主导数仓分层规范设计与落地,完成300余张核心表模型重构,口径统一率提升至95%。
- 通过分区裁剪与小文件合并优化,存储成本下降25%,任务平均耗时降低35%。
实时日志接入与离线同步平台 - 核心开发
2022年12月 - 2023年2月
- 基于Kafka与Sqoop搭建日志接入与离线同步链路,支持20余个业务系统数据入仓。
- 设计断点续传与失败重试机制,数据同步成功率由96%提升至99.8%。
教育背景
浙江工业大学
一本省重点
杭州
计算机科学与技术 本科
2016年8月 - 2020年5月
主修数据库系统、数据结构与大数据技术,GPA 3.6/4.0,通过CET-6。
证书与认证
阿里云大数据工程师认证(ACP) - 阿里云
2023年6月
证明云上大数据计算与数据开发能力。
数据库系统工程师(软考中级) - 工业和信息化部
2021年11月
证明数据库设计与数据管理能力。
其他信息
到岗时间:
在职,一个月内可到岗。
工作意愿:
可接受短期出差,意向杭州、上海地区。
更多Hadoop简历范文
同一职位,不同的版式和写法。点开任意一份即可查看大图。
就从这份范文开始
免费复制到你的账户里,每一句话、每个板块和颜色都能改,改好即可下载投递。