


人工智能研究员简历范文全文

自我评价
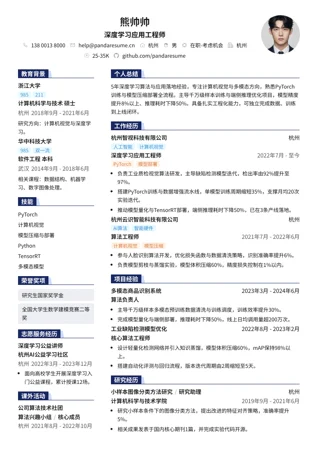
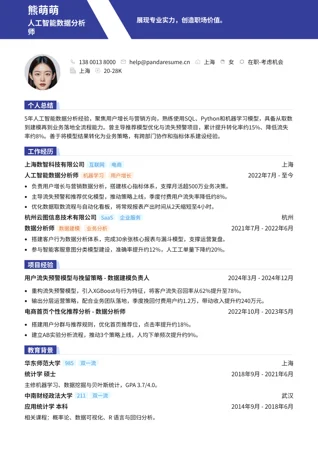
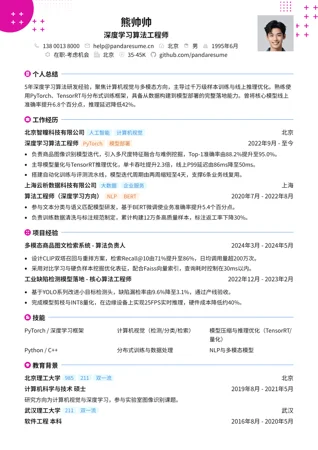
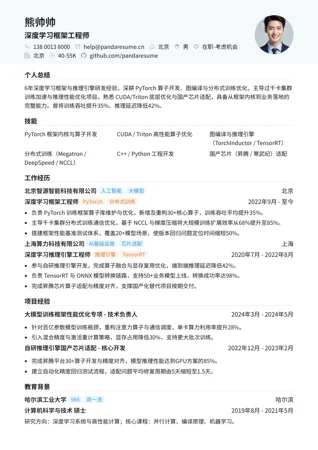
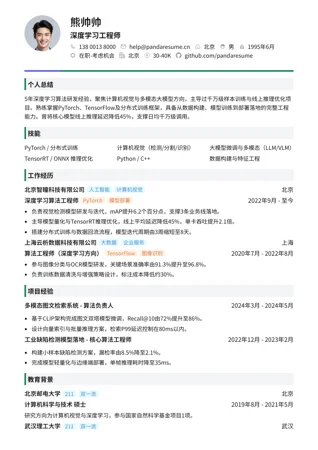
5年人工智能研究经验,专注大模型预训练与多模态理解方向,主导过千亿参数模型的数据与对齐工作。熟悉PyTorch分布式训练与RLHF全流程,在NeurIPS、ACL等顶会发表论文4篇。擅长将研究成果落地为业务指标,推动模型推理成本下降与效果提升。
教育背景
清华大学
985211双一流
北京
计算机科学与技术 博士
2016年9月 - 2021年6月
研究方向:自然语言处理与多模态学习;以一作发表CCF-A类论文2篇。
中国科学技术大学
985211双一流
合肥
计算机科学与技术 本科
2012年9月 - 2016年6月
相关课程:机器学习、概率统计、算法设计。
工作经历
北京智源智能科技有限公司
大模型人工智能
北京
人工智能研究员
大模型预训练RLHF
2021年7月 - 至今
- 负责千亿参数大模型预训练数据配比与课程学习策略,训练效率提升约25%。
- 主导RLHF对齐流程搭建,模型在内部评测集上的有用性得分提升12个百分点。
- 推动推理侧量化与蒸馏方案落地,单次推理成本下降约40%。
北京云图数据技术有限公司
计算机视觉企业服务
北京
算法研究实习生
多模态模型训练
2020年7月 - 2021年6月
- 参与多模态图文检索模型研发,线上召回率由78%提升至89%。
- 负责数据清洗与标注规范设计,标注返工率下降约30%。
研究经历
长文本语义理解与建模 - 博士研究生(第一作者)
北京
计算机科学与技术系
2017年9月 - 2021年6月
- 提出面向长文本的多粒度注意力机制,在三个公开数据集上取得当时最优效果。
- 独立完成实验设计与消融分析,成果发表于ACL主会。
多模态大模型对齐方法研究 - 核心研究员
北京
人工智能研究院
2022年3月 - 2023年12月
- 构建中文多模态指令数据集,覆盖约50万条样本。
- 设计跨模态对齐损失函数,图文匹配准确率提升6个百分点。
项目经验
千亿参数大模型预训练平台建设 - 技术负责人
2023年1月 - 2024年8月
- 设计分阶段训练与数据去重流程,训练吞吐提升约20%。
- 搭建自动化评测流水线,模型迭代周期由两周缩短至五天。
大模型RLHF对齐系统 - 核心研发
2022年6月 - 2023年10月
- 实现基于人类反馈的奖励模型与PPO训练流程,对齐效果显著优于SFT基线。
- 建立安全评测集,有害输出率下降约35%。
工作成果
顶会论文产出
以第一作者在NeurIPS、ACL发表论文4篇,累计引用超过200次。
推动成果落地
牵头完成公司首个千亿参数模型对齐方案,支撑3条业务线接入。
年度技术创新奖
获公司年度技术创新奖,团队排名前5%。
专业技能
PyTorch / 分布式训练
大模型预训练与微调
RLHF / 对齐算法
Python / C++
多模态学习
论文写作与实验设计
荣誉奖项
清华大学优秀博士毕业生
全国大学生数学建模竞赛一等奖
证书与认证
人工智能工程师(软考中级) - 工业和信息化部
2023年6月
证明深度学习框架与模型部署能力。
华为云AI工程师认证(HCIP-AI) - 华为
2022年9月
证明云计算平台与GPU集群使用能力。
语言能力
英语(CET-6,学术写作熟练)可熟练阅读英文论文并撰写英文投稿
就从这份范文开始
免费复制到你的账户里,每一句话、每个板块和颜色都能改,改好即可下载投递。